בדקנו חמש דרכים ליצור תמונה פנורמית לחדר אימרסיבי בבינה מלאכותית
פרומפט אחד וחמש דרכים ליצור פנורמה של 5760 על 1080 בבינה מלאכותית (נמדדו ב־4 בנובמבר 2026): כמה עולה כל שיטה, כמה זמן היא לוקחת ובאיזו מהן מתקבלת חדות אמיתית על הקירות.
מאת 3walls · פורסם ב־
השאלה: איך יוצרים פנורמה לחדר אימרסיבי
בחדר אימרסיבי תמונה אחת נפרשת ברצף על פני שלושה קירות. כל קיר מציג רזולוציה של 1920 על 1080, כך שהתמונה השלמה מגיעה ל־5760 על 1080 פיקסלים – יחס רוחב־גובה של 16:3, שהוא רחב במיוחד.
לא פשוט לייצר תמונה ביחס כזה. היא רחבה בהרבה מתמונה רגילה, ומבין כל מודלי הבינה המלאכותית שבדקנו, רק מודל אחד ידע לייצר ישירות קובץ של 5760 על 1080. בגלל המגבלה הזו התפתחו כמה שיטות עבודה שונות להגיע לאותו גודל – וכל אחת מהן נותנת תוצאה אחרת לגמרי על הקיר.
רצינו לבדוק באופן מעשי: איזו שיטה נותנת הכי הרבה פרטים אמיתיים, כמה כל אחת עולה, וכמה זמן לוקח להפיק אותה?
לקחנו תיאור כתוב אחד (פרומפט), הרצנו אותו בחמש שיטות שונות ב־4 בנובמבר 2026, ומדדנו את התוצאות.
מה גילינו בהשוואה בין חמש השיטות
איך בדקנו את חמש השיטות
לכל חמש השיטות הזנו בדיוק את אותו פרומפט באנגלית:
A calm mountain lake at sunrise, ultra wide panoramic landscape, a small wooden sailboat near the centre, pine forests on both shores, layered blue mountain ridges, warm low sun, photorealistic, no people, no text.
הרצנו כל שיטה פעם אחת דרך API (פנייה ישירה למודל מתוך קוד, ולא עבודה ידנית בממשק צ׳אט). המחירים נקובים בדולרים לפי החיוב בפועל ב־fal (הפלטפורמה שדרכה הרצנו את המודלים) נכון ליום הבדיקה. זמני הריצה כוללים גם את זמן ההמתנה בתור של השרת, שעשוי להשתנות בין הרצות: כך למשל אותו מודל בדיוק, FLUX.2, רץ במשך 68 שניות בשיטה 2, אבל בשיטה 4 הוא סיים תמונה גדולה יותר תוך 16 שניות בלבד.
בכל תוצאה בדקנו שני מדדים:
- אחוז הפיקסלים המקוריים מהמודל: איזה חלק מהפיקסלים בתמונה הסופית נוצר באמת על ידי מודל התמונה עצמו (בניכוי פיקסלים שאבדו אם התמונה הוקטנה באמצע התהליך). כל שאר הפיקסלים הם השלמה של כלי ההגדלה.
- ציון החדות: מדד מתמטי מקובל לחדות תמונה (Laplacian variance על התמונה בגווני אפור), שבודק עד כמה המעברים והקצוות בתמונה חדים. אפשר להשוות אותו רק בין סצנות דומות, וחשוב לזכור שהוא מתגמל גם חדות מלאכותית או קווי תפר: שלושה קירות שנוצרו בנפרד עם קווי תפר חדים ביניהם קיבלו את הציון הגבוה ביותר (950). בדיוק בגלל זה צירפנו בהמשך גם תקריבים בגודל מלא (100%), כדי שתוכלו לשפוט בעצמכם.
אלה השמות המדויקים של המודלים שבהם השתמשנו ב־fal:
- Seedream 4.5: fal-ai/bytedance/seedream/v4.5/text-to-image
- FLUX.2: fal-ai/flux-2
- FLUX.2 Pro Outpaint: fal-ai/flux-2-pro/outpaint
- SeedVR: fal-ai/seedvr/upscale/image
- Hunyuan World: fal-ai/hunyuan_world
- Nano Banana 2: fal-ai/nano-banana-2
במודלים שתומכים בכך (Seedream, FLUX.2 ו־Nano Banana 2) קבענו מראש את אותו מספר התחלתי (seed 20261104) כדי לשמור על השוואה הוגנת.
מה באמת קורה כשמגדילים תמונה עם בינה מלאכותית
אף אחד מהמודלים שבדקנו לא הצליח לייצר במכה אחת תמונה ברוחב 5760 פיקסלים שגם שומרת על עושר אמיתי של פרטים. לכן ברוב המקרים מייצרים תמונה קטנה יותר ואז מגדילים אותה – וארבע מתוך חמש השיטות במדריך הזה נשענות על שלב הגדלה כזה.
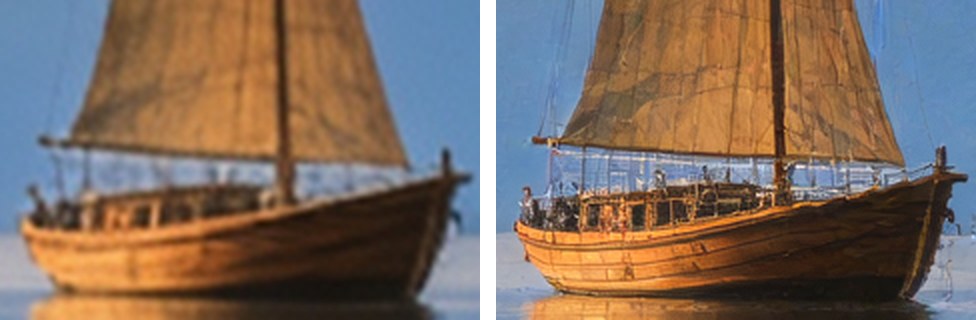
הגדלה רגילה פשוט מותחת את הפיקסלים הקיימים. התמונה אומנם מגיעה לגודל הנדרש, אבל הופכת למטושטשת ולא מתווסף בה שום מידע חדש.
הגדלה חכמה ב־AI, לעומת זאת, נעשית בכלי (Upscaler) שאומן על מיליוני תמונות ויודע איך מרקמים בטבע אמורים להיראות. בזמן ההגדלה הוא מוסיף ומחדד פרטים קטנים שלא היו בקובץ המקורי. זה קצת כמו לבקש מצייר מוכשר לצייר מחדש צילום מטושטש של יער, והפעם בחדות: העצים יישארו בדיוק באותו מקום וייראו משכנעים מאוד, אבל הענפים הקטנים ומחטי האורן יגיעו מהידע של הצייר על יערות – ולא מהצילום עצמו.
למה חשוב להבחין בין פרטים מקוריים להשלמה של ההגדלה
הפרטים שמוסיף כלי ההגדלה נראים חדים ומשכנעים, אבל הם השלמה אוטומטית שמתבססת רק על התמונה הקטנה – בלי שהכלי בכלל מכיר את הפרומפט שכתבתם. כשאנחנו כותבים "פרטים אמיתיים", הכוונה היא לפרטים שמודל התמונה יצר ישירות מתוך הפרומפט. בנופים כמו עצים, מים או עננים ההשלמה הזו עובדת מצוין, כי לאף אחד לא משנה איך בדיוק נראה כל עלה. זה כן קריטי כשצריך דיוק מוחלט: כיתוב, תווי פנים, מפות או מבנים היסטוריים מוכרים.
הרחבת תמונה (Outpainting), שבה נשתמש בשיטות 3 ו־4, עובדת על עיקרון אחר: נותנים לבינה המלאכותית תמונה קיימת ומבקשים ממנה להמשיך לצייר מעבר לשוליים שלה. גם כאן המודל משלים מידע חדש, רק שבמקום להמציא מרקמים זעירים הוא בונה אזורים שלמים משני צידי התמונה.
התוצאות: השוואה בין חמש השיטות
| שיטה | מורכבות | אופן ההפקה | עלות לתמונה | זמן הפקה | ציון חדות | פיקסלים מקוריים (בקירוב) | מתי מתאימה | מתי פחות מתאימה |
|---|---|---|---|---|---|---|---|---|
| 1. רחבה במכה אחת | נמוכה | API או הצ׳אט של Gemini | $0.047 | 27 שניות | 430 | 25% | הפקה מהירה וזולה | כשפריט חייב להופיע על קיר מסוים |
| 2. קטנה, ואז הגדלה | נמוכה | API | $0.031 | 80 שניות | 301 | 20% | מודלים שלא תומכים ברוחב מלא | כשמתבוננים בפרטים קטנים מקרוב |
| 3. הרחבת הצדדים | בינונית | API | $0.247 | 44 שניות | 506 | 20% | כשיש תמונה קיימת לקיר המרכזי | כשחייבים לשמור על החדות המלאה של המקור |
| 4. קיר אחר קיר | גבוהה | API; בדיקת חיבורים ידנית | $0.624 | 74 שניות | 632 | 100% | מקסימום פרטים אמיתיים | כשרוצים לקבוע בנפרד מה יוצג על כל קיר |
| 5. פנורמה של 360° | גבוהה | API וקוד לתיקון הפרספקטיבה | $0.197 | 663 שניות (כ־11 דקות) | 449 | 7% | כשרוצים לסובב את זווית המבט | כשצריך תוצאה מהירה או חדות גבוהה |
בדקנו גם מה קורה כשמבקשים ישירות משתי אפליקציות צ׳אט נפוצות ליצור תמונה של אגם הררי שקט בזריחה בגודל 5760 על 1080 בדיוק. הצ׳אט של Gemini (במסלול Pro, מודל Flash) החזיר תוך כ־20 שניות תמונה עם מרקם עשיר ומשכנע, אם כי רעשי הדחיסה של הקובץ מעלים מעט את ציון החדות שלו (543). ChatGPT (במודל Pro) אומנם החזיר קובץ בגודל המדויק, אבל לפי הפירוט שלו עצמו הוא יצר בפועל תמונה של 2172 על 724 פיקסלים, חתך אותה ומתח אותה לגודל המבוקש.
בניסיון נוסף דרך API עם מודל התמונה של Gemini ב־fal (הנקרא Nano Banana 2), ביחס הרחב ביותר ובגודל המקסימלי שלו, קיבלנו קובץ ענק של 11712 על 1408 פיקסלים – אבל בצפייה בגודל מלא התמונה יצאה רכה ולא מספיק חדה.
שיטה 1: ליצור את הפנורמה ברוחב מלא במכה אחת
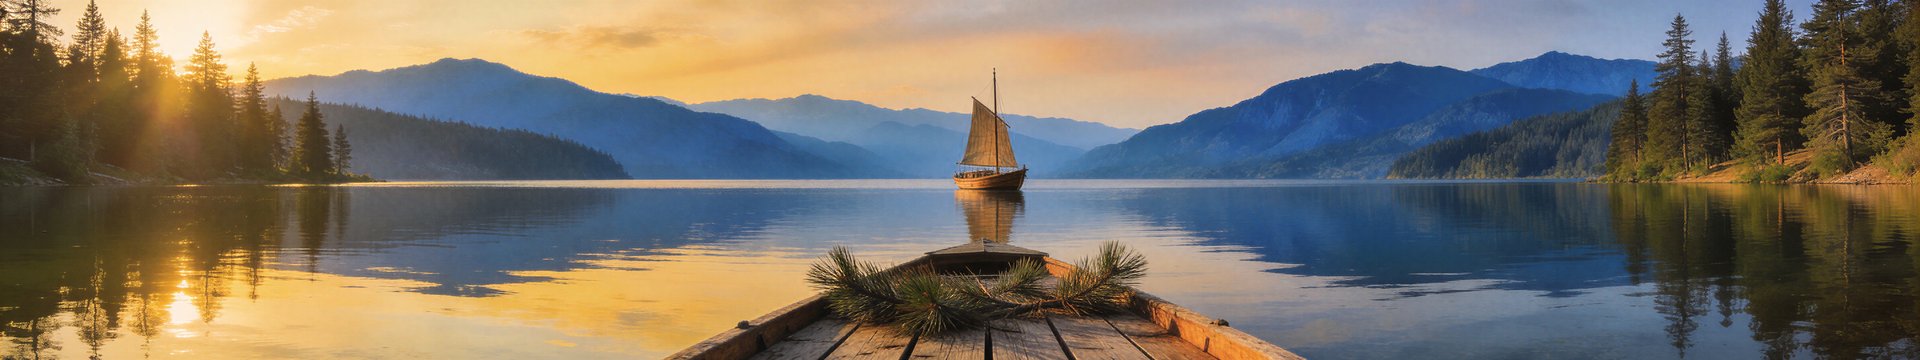
- המודל Seedream 4.5 מייצר ישירות מהפרומפט תמונה בגודל המלא – 5760 על 1080. אי אפשר לבקש ממנו מראש תמונה בחצי מהגודל הזה: כשביקשנו 2880 על 540, ה־API החזיר תמונה בגודל 8736 על 1920 – גם גודל אחר וגם יחס אחר. התמונה של 5760 על 1080 יוצאת בגודל הנכון, אבל כשמתקרבים לקיר רואים שרמת הפירוט האמיתית שלה מתאימה בערך לחצי מהרזולוציה הזו.
- לכן מקטינים את התמונה בחצי, ל־2880 על 540. מכיוון שכלי ההגדלה (Upscaler) יודע להוסיף ולחדד פרטים רק כשהוא מגדיל תמונה, נותנים לו נקודת פתיחה קטנה יותר. ומאחר שהפרטים הזעירים ממילא לא היו שם באמת, ההקטנה כמעט לא מאבדת מידע.
- מגדילים בחזרה פי 2 ב־AI לגודל 5760 על 1080 – והשלב הזה הוא מה שנותן לתמונה את החדות שלה. עם זאת, תמונה בחצי רוחב ובחצי גובה מכילה רק רבע מכמות הפיקסלים, כך שאת שלושת הרבעים הנותרים משלים כלי ההגדלה.
יתרונות
- זו שיטת ברירת המחדל שלנו ב־3walls.
- המהירה ביותר מבין חמש השיטות (27 שניות).
חסרונות
- פחות שליטה על פרטי הקומפוזיציה: בבדיקה שלנו, למשל, המודל הוסיף על דעת עצמו, בקדמת התמונה, דק עץ שלא ביקשנו בפרומפט.
מתי להשתמש: כשרוצים להפיק רקע שלם במהירות ואפשר לתת למודל חופש בבניית הסצנה.
מתי לוותר: כשהמיקום המדויק של פריטים על כל קיר חשוב יותר ממהירות ההפקה.
שיטה 2: ליצור פנורמה קטנה ואז להגדיל אותה
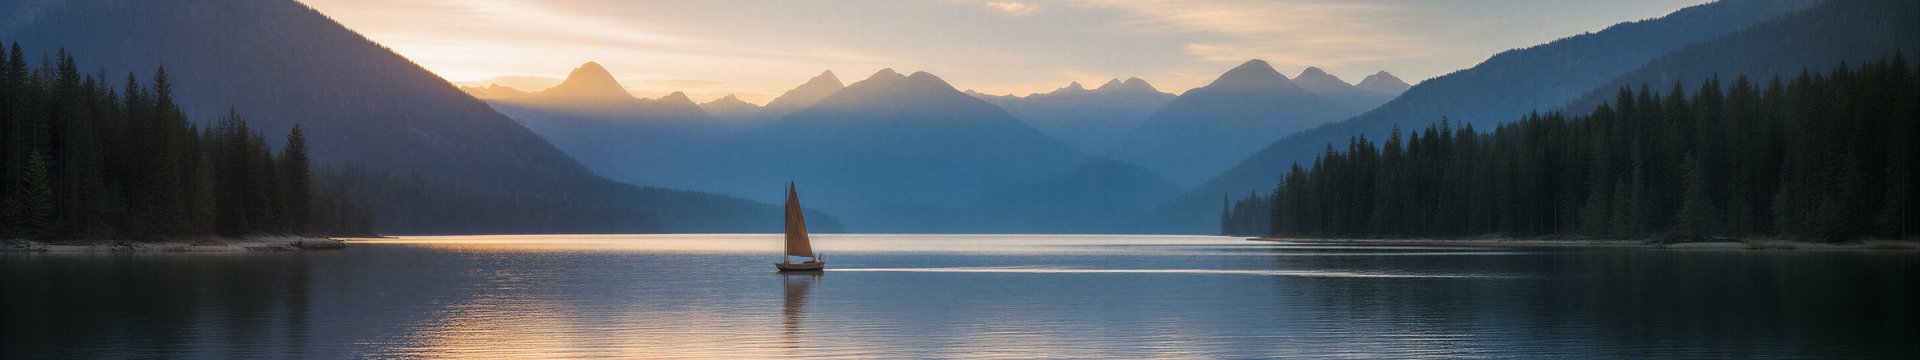
- המודל FLUX.2 מייצר תמונה בגודל 2560 על 480. זו התמונה הרחבה ביותר ביחס 16:3 שהמודל הזה מסוגל להפיק ב־fal, והיא מכילה רק כחמישית מכמות הפיקסלים שנדרשת לשלושת הקירות.
- מגדילים את התמונה פי 2.25 לגודל 5760 על 1080 (כי 2560 כפול 2.25 נותן בדיוק את רוחב שלושת הקירות – 5760). את ארבע החמישיות החסרות של הפיקסלים משלים כלי ההגדלה.
יתרונות
- הזולה ביותר מבין חמש השיטות ($0.031 לתמונה).
חסרונות
- רוב הפרטים הקטנים (80%) הם השלמה של כלי ההגדלה ולא נוצרו ישירות מהפרומפט.
מתי להשתמש: כשעובדים עם תקציב מצומצם או עם מודל מועדף שלא תומך ברזולוציות רחבות.
מתי לוותר: כשהמשתתפים בחדר יעמדו קרוב לקירות ויבחנו פרטים קטנים מקרוב.
שיטה 3: להרחיב תמונה קיימת לצדדים (Outpainting)
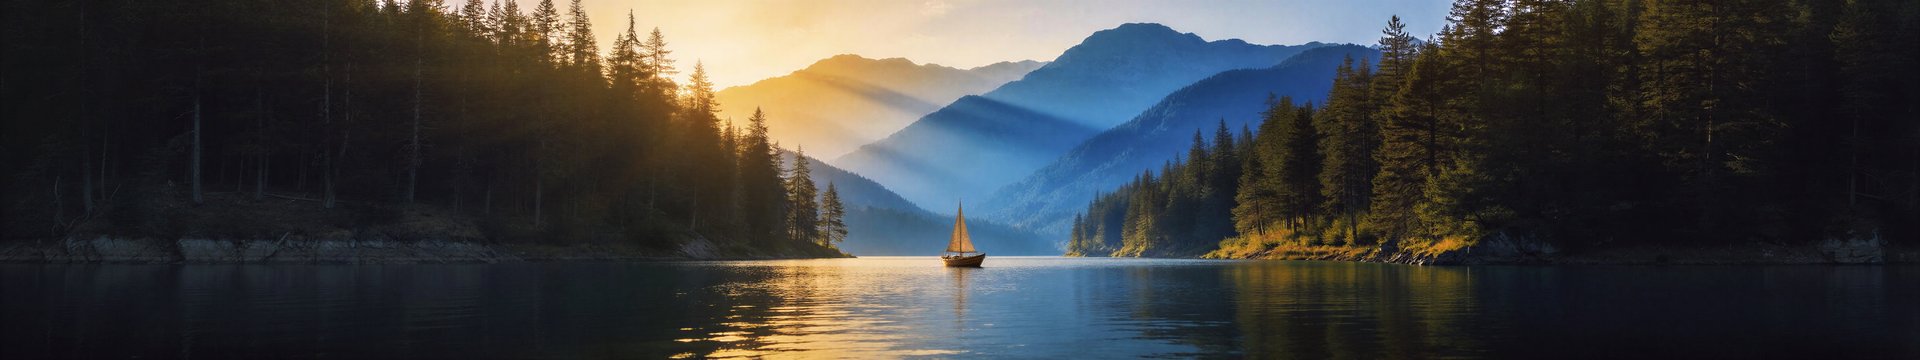
- מתחילים מתמונה רגילה ביחס 16:9 שמתאימה לקיר בודד (1920 על 1080) – זו התמונה שתרצו להציג על הקיר המרכזי בחדר.
- מקטינים אותה ל־853 על 480 וממקמים אותה במרכז קנבס ריק בגודל 2560 על 480. כלי ההרחבה תומך ברוחב מקסימלי של 2560 פיקסלים, ולכן כל הפנורמה חייבת להיכנס תחילה למסגרת הזו, שבה התמונה המקורית תופסת את השליש האמצעי.
- כלי ההרחבה מצייר ומשלים את השטחים הריקים מימין ומשמאל כך שימשיכו באופן טבעי את התמונה המרכזית.
- מגדילים את הקנבס כולו פי 2.25 לגודל הסופי – 5760 על 1080. בגלל ההקטנה וההגדלה מחדש, גם התמונה המקורית שבמרכז מאבדת מעט מהחדות ההתחלתית שלה.
יתרונות
- מאפשרת להתבסס על תצלום קיים, איור או תמונה שכבר יצרתם ואהבתם.
חסרונות
- גם תמונת מקור חדה מאבדת מעט חדות בגלל ההקטנה וההגדלה.
- אין שליטה במה שיופיע על קירות הצד: כלי ההרחבה הזה משלים את התמונה לבד ולא מקבל פרומפט טקסטואלי.
מתי להשתמש: כשיש לכם תמונה מרכזית מוכנה שחשוב לשמור עליה בלב החדר.
מתי לוותר: כשחשוב לכם להחליט בעצמכם מה בדיוק יופיע על הקירות הימני והשמאלי.
שיטה 4: לייצר קיר אחר קיר ולחבר ביניהם
- המודל מייצר תחילה את הקיר המרכזי בגודל מלא של 1920 על 1080, כך שלא נדרשת שום הגדלה בהמשך.
- ממשיכים שמאלה: נותנים לכלי ההרחבה רצועה ברוחב 640 פיקסלים מהקצה השמאלי של הקיר המרכזי, ומבקשים ממנו להשלים קיר חדש ברוחב 1920 פיקסלים. המודל חייב לראות את קצה התמונה כדי להמשיך אותה בצורה חלקה, ו־640 ועוד 1920 נותנים 2560 – הרוחב המקסימלי שהכלי מסוגל לעבד בפעם אחת.
- חוזרים על אותה פעולה לצד ימין ומחברים את שלושת החלקים: שלושה קירות של 1920 נותנים פנורמה של 5760 על 1080 שבה 100% מהפיקסלים נוצרו ישירות על ידי מודל AI.
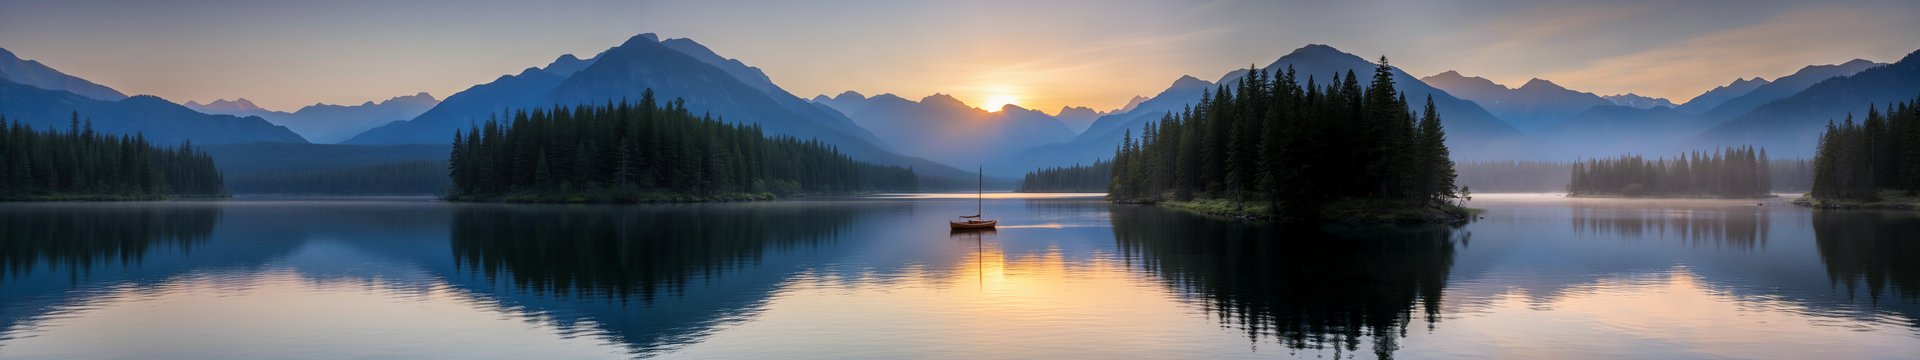
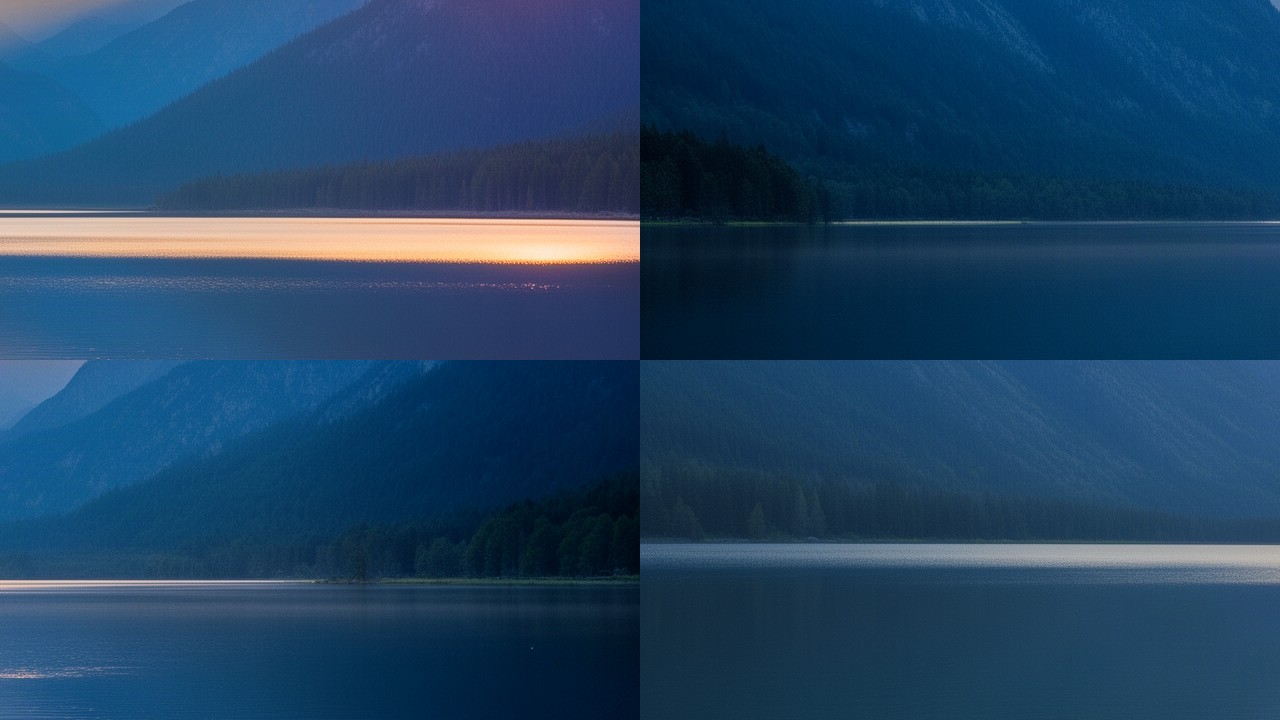
בשיטה הזו קירות הצד ממשיכים ישירות מתוך שולי הקיר המרכזי: המעברים בין הקירות יוצאים חלקים לגמרי, אבל הבינה המלאכותית היא זו שמחליטה מה לצייר בצדדים. לעומת זאת, אם מייצרים כל קיר בנפרד עם פרומפט משלו, מקבלים שליטה מלאה על התוכן בכל קיר – אבל אז רואים קו תפר חד וברור בפינות החדר:
יתרונות
- 100% מהפיקסלים נוצרים ברזולוציה מלאה על ידי המודלים, ללא שום הגדלה.
חסרונות
- השיטה היקרה ביותר מבין החמש ($0.624 לתמונה).
מתי להשתמש: כשהמשתתפים עומדים קרוב לקירות וחשוב לקבל פירוט אמיתי וחד שמצדיק את העלות.
מתי לוותר: כשחייבים לקבוע בנפרד מה יופיע על כל קיר – במקרה כזה עדיף לייצר שלושה קירות נפרדים ולקחת בחשבון שיראו את קווי התפר בפינות.
שיטה 5: ליצור פנורמת 360° ולחתוך ממנה את זווית המבט של החדר
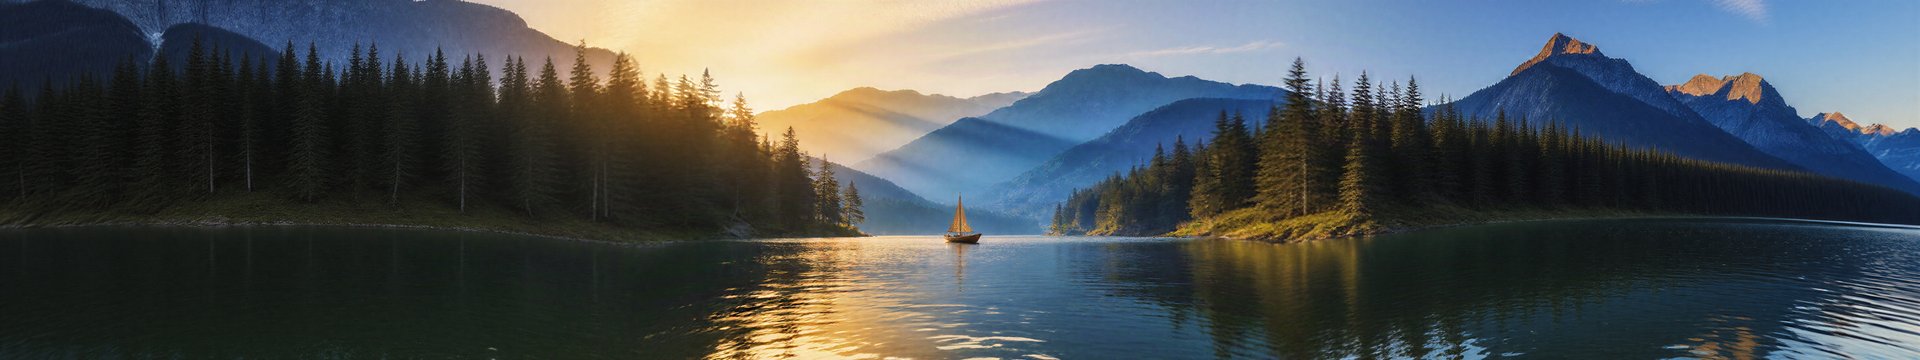
- מודל ייעודי הופך תמונה רגילה לפנורמת 360° שמקיפה את הצופה מכל הכיוונים. הכלי החזיר תמונה בגודל 1920 על 960 בלבד – וזו כל כמות הפרטים שעומדת לרשותנו בשלבים הבאים.
- גוזרים מתוך הפנורמה את הרצועה שמופיעה על שלושת הקירות ומיישרים את הפרספקטיבה שלה, משום שתמונת 360° מעקמת קווים ישרים ואילו קירות החדר שטוחים. כשעומדים במרכז החדר, כל קיר תופס רבע מהמעגל שמסביב, כך ששלושה קירות מציגים שלושה רבעים מהפנורמה – כ־1440 פיקסלים מתוך ה־1920 של הרוחב המקורי. מותחים את הרצועה הזו לגודל 2880 על 540 (חצי מגודל הקירות) כהכנה להגדלה. המתיחה עצמה לא מוסיפה פרטים, ולכן בשלב הזה התמונה עדיין רכה.
- מגדילים פי 2 ב־AI לגודל הסופי של 5760 על 1080. בפועל רק כ־7% מהפיקסלים בתמונה הסופית הגיעו מהמודל המקורי, ואת כל השאר משלים כלי ההגדלה.
יתרונות
- הפרספקטיבה מותאמת להיטל של שלושת קירות החדר.
חסרונות
- האיטית ביותר בפער גדול (כ־11 דקות), כשכמעט כל הזמן מוקדש ליצירת פנורמת ה־360°.
מתי להשתמש: כשרוצים לשמור אפשרות לסובב את זווית המבט בחדר בהמשך, כי הפנורמה כבר מכילה גם את מה שנמצא "מאחורי הגב" של הצופה.
מתי לוותר: כשצריך תוצאה מהירה או חדות גבוהה מקרוב.
תשפטו בעצמכם: תקריבים בגודל מלא (100%) מכל שיטה
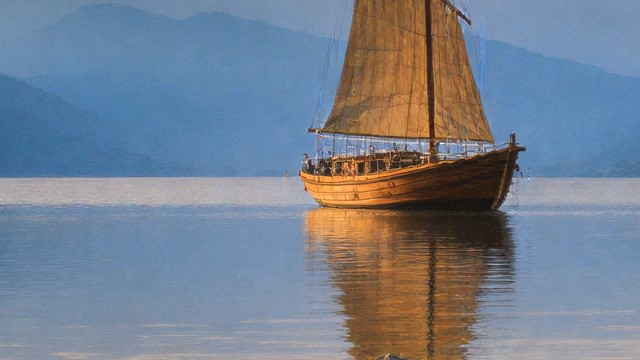
התקריבים הבאים נגזרו בגודל מלא (100%) מאותו מלבן קבוע בכל אחת מהתמונות. מכיוון שכל מודל מיקם את הסירה קצת אחרת, תוכן התקריב משתנה מתמונה לתמונה (רק בשיטות 1, 4 ו־5 הסירה כולה נכנסה למסגרת). לכן מומלץ להשוות את חדות המרקם והפרטים, ולא את מיקום הסירה.
מגבלות הבדיקה
- בדקנו פרומפט אחד של נוף טבעי ללא דמויות אנושיות וללא טקסט. בסצנות אחרות התוצאות עשויות להיראות אחרת.
- כל שיטה הורצה פעם אחת בלבד, כך שהמספרים מייצגים דוגמה מעשית מתועדת ולא ממוצע סטטיסטי.
- גם מחירי ה־API וגם המודלים עצמם מתעדכנים בתדירות גבוהה.
- לא בדקנו כאן יצירה של עולמות תלת־ממדיים מלאים (כמו Marble או הפלט התלת־ממדי של Hunyuan World, ששיטה 5 משתמשת רק בפנורמה הדו־ממדית שלו). עולמות כאלה מאפשרים גם תנועת מצלמה בתוך המרחב, אך דורשים מספר דקות של עיבוד לכל עולם.
בשורה התחתונה: איזו שיטה כדאי לבחור לחדר אימרסיבי?
על סמך המדידה שערכנו, זו נקודת הפתיחה המומלצת לפי הצורך שלכם:
- הכי מהיר ומשתלם: שיטה 1 (ברירת המחדל שלנו), או שיטה 2 אם העלות לתמונה היא השיקול המרכזי.
- כשיש תמונה מוכנה שרוצים להציג על הקיר המרכזי: שיטה 3, שמתחילה מהתמונה שלכם ומרחיבה אותה לצדדים.
- מקסימום חדות ופרטים אמיתיים: שיטה 4 (קיר אחר קיר), בתנאי שהעלות מתאימה לכם ושאין בעיה לתת לבינה המלאכותית להחליט איך ייראו קירות הצד.
- כשרוצים אפשרות לסובב את הסצנה לכל כיוון: שיטה 5, אם אפשר להמתין כ־11 דקות להפקה.
- בלי קוד ובלי API, ישירות מתוך צ׳אט: הצ׳אט של Gemini, שנתן את התוצאה הטובה ביותר בבדיקת הצ׳אטים שלנו – צריך רק להגדיל את התמונה שהוא מייצר בערך פי 1.2 ולחתוך מעט כדי שתתאים בדיוק לשלושת הקירות.
כשמדובר בתמונה מרכזית וחשובה לפעילות בחדר, הכי כדאי להריץ שתי שיטות במקביל ולהשוות את התוצאות בגודל מלא.