בדקנו ארבע דרכים להפוך פנורמה של חדר אימרסיבי לווידאו בבינה מלאכותית
פנורמה אחת של אגם וארבע דרכים להכניס בה תנועה בעזרת בינה מלאכותית (נמדדו ב־8 וב־9 בנובמבר 2026): כמה עולה כל שיטה ל־10 שניות וידאו, כמה זמן היא לוקחת, כמה חדה התמונה נשארת ואיך הסרטון חוזר על עצמו בלולאה.
מאת 3walls · פורסם ב־ · עודכן ב־
השאלה: איך מכניסים תנועה לפנורמה של חדר אימרסיבי
בחדר אימרסיבי תמונה אחת נפרשת ברצף על פני שלושה קירות. כל קיר מציג 1920 על 1080, כך שהתמונה השלמה מגיעה ל־5760 על 1080 פיקסלים. בחלק הראשון של הסדרה השווינו חמש דרכים ליצור את התמונה הזו כתמונה סטטית. בחלק הזה אנחנו מכניסים בה תנועה: אדוות במים, ערפל שנע, אור שמשתנה.
מודלי וידאו מבוססי בינה מלאכותית יודעים להנפיש תמונה סטטית, אבל אף אחד ממודלי הווידאו שעבדנו איתם לא יצר וידאו בגודל 5760 על 1080: הסרטון הרחב ביותר שקיבלנו היה 3324 על 622. לתמונה שזזה יש גם שתי בעיות שאין לתמונה סטטית: נקודות החיבור בין הקירות חייבות להמשיך להתאים זו לזו, ואם הסרטון מוקרן שוב ושוב, הסוף שלו צריך להתחבר בחזרה להתחלה.
רצינו לבדוק: איזו דרך נותנת הכי הרבה תנועה ופרטים אמיתיים, כמה כל אחת עולה, כמה זמן היא לוקחת, ואיך כל אחת מתחברת ללולאה?
לקחנו תמונה אחת, העברנו אותה בארבע שיטות שונות ב־8 בנובמבר 2026 ומדדנו את התוצאות. ב־9 בנובמבר הרצנו את שיטה 3 פעם נוספת, על מודל וידאו אחר.
מה גילינו בהשוואה בין ארבע השיטות
איך בדקנו את ארבע השיטות
נקודת המוצא היא הפנורמה של שיטה 4 מהחלק הראשון, קיר אחר קיר: אגם בזריחה עם סירת מפרש קטנה, ברזולוציה המלאה של 5760 על 1080. לא מצאנו את הקובץ המדויק שפרסמנו, ולכן יצרנו אותו מחדש באותה שיטה ובאותו סקריפט: תמונה חדשה של אותה סצנה, שנוצרה בדיוק באותה דרך.
כל שיטה שמקבלת תיאור של התנועה קיבלה את אותו פרומפט באנגלית:
Gentle ripples on the lake, the sailboat drifting slightly, mist moving over the pines, fixed camera.
(בעברית: אדוות עדינות באגם, סירת המפרש נסחפת מעט, ערפל נע מעל עצי האורן, מצלמה קבועה.) בשיטה 2 הוספנו רמז שעוזר ללולאה: "seamless looping motion, settling back toward the opening". שיטה 1 לא מקבלת תיאור, כי אין בה מודל AI בכלל.
ביקשנו סרטונים של 10 שניות, והרצנו את כל השיטות דרך wallvideo-service – השירות שבו אנחנו משתמשים ב־3walls כדי להפיק וידאו לקירות – כשמודלי ה־AI רצים ב־fal. בכתבה מוצגת הרצה אחת של כל שיטה; שיטה 3 הורצה ארבע פעמים ב־8 בנובמבר ופעם נוספת, על Wan 3.0, ב־9 בנובמבר. המחירים הם החיוב בפועל של fal על כל בקשה, בדולרים, נכון ליום הבדיקה; המתכנן של שיטה 3 רץ על Gemini של Google ומתומחר לפי המחירון הרשמי של Google. הזמנים נמדדו משליחת כל בקשה ועד קבלת התוצאה, ולכן כוללים גם המתנה בתור, שמשתנה מהרצה להרצה: אותו כלי הגדלה, Topaz, עבד 329 שניות בשיטה 2 ו־914 שניות בשיטה 4, על סרטונים באותו גודל בדיוק. הזמן שעבר על המחשב שלנו, בהתאמת הסרטון לקירות ובקידוד שלו, מופיע בנפרד.
אלה השמות המדויקים של המודלים ב־fal:
- Wan 3.0: alibaba/wan-3.0/image-to-video
- Topaz: topaz/upscale/video/generative
- SeedVR: fal-ai/seedvr/upscale/video
- LTX-2.3: fal-ai/ltx-2.3/image-to-video/fast
- LTX-2 19B: fal-ai/ltx-2-19b/image-to-video
- Seedream 4.5 Edit: fal-ai/bytedance/seedream/v4.5/edit
המתכנן של שיטה 3 הוא Gemini 3.8 Flash (gemini-3.8-flash), ב־Vertex AI של Google.
בכל סרטון שהתקבל מדדנו:
- רזולוציה אמיתית: הגודל של הסרטון שמודל הווידאו יצר בפועל, לפני הגדלה או התאמה לקירות.
- החלק שמשתנה: איזה חלק מהתמונה של 5760 על 1080 משתנה באופן שנראה לעין ברגע כלשהו, בהשוואה לפריים הראשון של הסרטון (בבלוקים של 4 על 4 פיקסלים, בשינוי של יותר מ־3 רמות בהירות מתוך 255). המדד סופר כל שינוי נראה לעין: זום מזיז כמעט כל פיקסל, וגם הר שהמודל מצייר מחדש בשינוי קל נספר.
- הקפיצה בלולאה: עד כמה הפריים האחרון בסרטון שונה מהראשון, כהפרש בהירות ממוצע בסולם של 0 עד 255. ב־0 נקודת הלולאה בלתי נראית.
- ציון החדות: אותו מדד כמו בחלק הראשון (Laplacian variance), על חמישה פריימים לאורך הסרטון, ומדווח הערך האמצעי. ציון גבוה יותר פירושו תמונה חדה יותר; אפשר להשוות אותו רק בין סרטונים של הסצנה הזו.
התוצאות: השוואה בין ארבע השיטות
| שיטה | מורכבות | מה זז | רזולוציה אמיתית | עלות ל־10 שניות | זמן | לולאה | מתי מתאימה | מתי פחות מתאימה |
|---|---|---|---|---|---|---|---|---|
| 1. תנועת מצלמה | נמוכה | רק נקודת המבט: זום איטי | 5760 על 1080, התמונה המקורית עצמה | $0 | 86 שניות, על המחשב שלנו | הלוך־חזור: פנימה והחוצה | תנועה בחינם מכל תמונה | כשהסצנה עצמה צריכה לזוז |
| 2. סרטון רחב אחד | נמוכה | כל הסצנה | 3324 על 622, ואז הגדלה ומתיחה | $3.30 | כ־11 דקות | קדימה, עם מעבר הדרגתי | סצנה שזזה כיחידה אחת | כשמתבוננים בקירות מקרוב |
| 3. קיר אחר קיר | גבוהה | מים, ערפל והסירה, באזורים מסומנים | 1280 על 720 לכל קיר ב־Wan 3.0, ומתיחה פי 1.5 | $3.35 ב־Wan 3.0; ארבעה ניסיונות שנדחו ב־LTX-2.3 עלו $11.93 | כ־15 דקות | שנייה עודפת שממוזגת בהתחלה | נקודות חיבור שאסור שיזוזו | כשמשהו נע למרחק גדול על פני קיר |
| 4. מעבר בין תמונות | בינונית | כל הסצנה, מזריחה לדמדומים | 3324 על 622, ואז הגדלה ומתיחה | $3.30, ועוד $0.04 לתמונת הדמדומים | כ־21 דקות | הלוך־חזור: לדמדומים ובחזרה | שינוי באור או מעבר בין שעות היום | כשיש רק תמונה אחת |
נמדד ב־8 בנובמבר 2026, ושיטה 3 על Wan 3.0 נמדדה ב־9 בנובמבר. לכל שיטה מוצגת הרצה אחת: שיטה 3 הורצה ארבע פעמים על LTX-2.3 בלי שהתקבל סרטון, ואז פעם אחת על Wan 3.0, שמסרה סרטון. הזמנים בטבלה כוללים גם את זמן העיבוד אצל ספקי המודלים וגם את הזמן על המחשב שלנו: 605 ועוד 74 שניות בשיטה 2, 693 ועוד 185 שניות בשיטה 3, ו־1128 ועוד 125 שניות בשיטה 4.
שיטה 1: להזיז מצלמה על פני התמונה
- מתחילים מהתמונה הסטטית, 5760 על 1080. אין כאן מודל AI: wallvideo-service מזיז מצלמה וירטואלית על פני התמונה.
- המצלמה מתקרבת לאט, כשהיא מעוגנת בפינה השמאלית העליונה של התמונה, כך שהשוליים הימניים והתחתונים יוצאים בהדרגה מהמסגרת.
- היא מתרחקת בחזרה באותה דרך, כך שהסרטון נגמר בדיוק איפה שהתחיל: תנועה של 10 שניות הופכת לסרטון של 20 שניות שחוזר על עצמו בלי קפיצה.
שום דבר בסצנה לא זז, ובכל זאת 91% מהתמונה משתנים ברגע כלשהו: זום מזיז כל פיקסל, חוץ מאלה שליד הפינה הקבועה שלו. ציון החדות, 393, הוא הגבוה ביותר מבין הסרטונים שמדדנו, כי זו התמונה המקורית עצמה, מוגדלת מעט. עשר שניות של הקובץ המלא שוקלות 23.1 מגה־בייט.
יתרונות
- חינמית ומוכנה תוך דקה וחצי, בלי המתנה בתור.
- כל פיקסל מגיע מהתמונה המקורית, כך שאף פרט לא הולך לאיבוד.
חסרונות
- שום דבר בסצנה לא זז: המים, הסירה והערפל נשארים קפואים.
- בשיא הזום, השוליים הימניים והתחתונים של התמונה נחתכים.
מתי להשתמש: כשהתמונה טובה ומספיקה תחושה עדינה של תנועה.
מתי לוותר: כשרוצים שהמים, השמיים או הערפל יזוזו.
שיטה 2: להנפיש את כל הפנורמה כסרטון רחב אחד
- שולחים את כל התמונה, 5760 על 1080, יחד עם תיאור התנועה, למודל וידאו אחד – Wan 3.0 – כפריים הראשון של הסרטון. המודל שומר על הצורה הרחבה ולא חותך אותה.
- המודל מחזיר סרטון של 10 שניות בגודל 3324 על 622. כל הסצנה זזה, אבל בסרטון יש רק כשליש מהפיקסלים שהקירות צריכים.
- כלי הגדלה מבוסס AI, Topaz, מגדיל אותו פי 1.15 ל־3838 על 718 – עדיין פחות מרוחב הקירות, 5760.
- השירות מותח את התוצאה פי 1.5 ל־5760 על 1080. מתיחה לא מוסיפה פרטים, ולכן התמונה רכה יותר מהמקור.
86% מהתמונה משתנים במהלך הסרטון. ציון החדות הוא 43, לעומת 393 בתנועת המצלמה על התמונה המקורית – כאן רואים את המתיחה. הקובץ המלא, באורך 10 שניות, שוקל 33.7 מגה־בייט. היצירה עלתה $2.00 (276 שניות), וההגדלה $1.30 (329 שניות).
עם SeedVR במקום Topaz. שלחנו את אותו סרטון גם לכלי הגדלה אחר, SeedVR, ישירות ב־fal. הוא החזיר 5776 על 1088 – מספיק כדי לכסות את הקירות, כך שלא היה צורך למתוח דבר – וקיבל ציון חדות של 109, בערך פי 2.5 מה־43 של Topaz. הוא עלה $1.87, לעומת $1.30 של Topaz, ועבד 1457 שניות (כ־24 דקות), לעומת 329. עם SeedVR, השיטה כולה עלתה $3.87 ל־10 שניות. wallvideo-service משתמש ב־Topaz; אפשר להשוות בין השניים בהמשך, בפרק "תשפטו בעצמכם".
יתרונות
- כל הסצנה זזה כתמונה אחת, כך שתנועה יכולה לעבור מקיר לקיר.
- פשוטה: שולחים תמונה אחת ומקבלים סרטון אחד.
חסרונות
- המודל יצר רק כשליש מהפיקסלים של הקירות; כל השאר הוא הגדלה ומתיחה.
- עולה $3.30 ל־10 שניות, וההפקה לקחה כ־11 דקות.
מתי להשתמש: כשכל הסצנה צריכה לזוז והצופים רואים את הקירות ממרחק של כמה צעדים.
מתי לוותר: כשמתבוננים בפרטים קטנים מקרוב – במקרה כזה כדאי לשקול כלי הגדלה חד יותר, כמו SeedVR.
שיטה 3: להנפיש כל קיר בנפרד
בבדיקה שלנו השירות סירב לשיטה הזו ארבע פעמים על מודל הווידאו של ברירת המחדל, ואז מסר סרטון על מודל אחר, Wan 3.0, עם סימון לבדיקה. קודם נסביר איך היא אמורה לעבוד, ואחר כך מה קרה בפועל.
- מתכנן מבוסס Gemini קורא את התמונה ומסמן מה מותר לזוז בכל קיר ומה חייב להישאר קבוע. התמונה נחתכת לשלושה קירות של 1920 על 1080.
- מודל וידאו, כברירת מחדל LTX-2.3, מנפיש כל קיר כסרטון נפרד של 10 שניות, ברזולוציה המלאה של הקיר – 1920 על 1080. התנועה נשמרת רק באזורים המסומנים, ורצועה בשולי כל קיר נשארת תמיד זהה לתמונה המקורית, כך שנקודות החיבור בין הקירות לא יכולות לזוז.
- השירות בודק שאפשר להצמיד כל פריים בחזרה לתמונה המקורית. קיר שכל התמונה שלו נסחפת, כאילו המצלמה זזה, נפסל ונוצר פעם נוספת; אם גם הפעם הוא נכשל, השירות מסרב למשימה כולה.
- רק כששלושת הקירות יציבים הם מתחברים ל־5760 על 1080.
מה קרה על מודל ברירת המחדל. הרצנו את השיטה ארבע פעמים, ב־8 בנובמבר. בכל הפעמים הקיר השמאלי והקיר המרכזי ננעלו על התמונה המקורית. הקיר הימני – ערפל מעל מדרון מיוער וכהה – חזר בכל פעם עם מצלמה שזזה ומתקרבת לאט, בכל אחד מהסרטונים שהשירות בדק: שישה מתוך שישה. בכל אחד מהם, בין 214 ל־250 מתוך 264 הפריימים לא הצליחו להיצמד לתמונה המקורית. על שני סרטוני הקיר הימני הנוספים – היצירות מחדש בשני הניסיונות הראשונים – שילמנו, אבל הם לא הגיעו לבדיקה. לכן השירות לא מסר שום סרטון, במקום למסור קיר שנקודות החיבור שלו יזוזו ויתרחקו מהקירות השכנים. בניסיון האחרון ניסינו שינוי אחד: היצירה מחדש של קיר שנפסל עברה למודל אחר, LTX-2 19B, עם הגדרה שנועדה להשאיר את המצלמה יציבה. גם הסרטון שלו התקרב.
ארבעת הניסיונות עלו $2.91, $2.91, $2.92 ו־$3.19 – $11.93 בסך הכול – ונמשכו 313, 358, 322 ו־606 שניות (כ־27 דקות יחד). בכל ניסיון שילמנו על ארבעה סרטוני קיר – שלושת הקירות ועוד יצירה מחדש של הקיר הימני: $0.72 לכל סרטון LTX-2.3 של 12 שניות, $0.99 ליצירה מחדש ב־LTX-2 19B, ועוד 3 עד 4 סנט למתכנן.
ואז על Wan 3.0. המצלמה של הקיר הימני לא נסחפה באקראי. בכל סרטוני ה־LTX האי שבחזית גדל הרבה יותר מהגדה הרחוקה, כמו כשמצלמה נעה קדימה בתוך הסצנה, ושום הצמדה לתמונה המקורית לא יכולה לבטל את זה. Wan 3.0 השאיר את אותו חלק בתמונה יציב בשיטה 2, ולכן ב־9 בנובמבר ניסינו אותו על הקיר הימני לבדו, פעמיים, ב־$1.10 לסרטון: שני הסרטונים נשארו יציבים, ואפשר היה להצמיד כל פריים לתמונה המקורית. אחר כך הרצנו את השיטה כולה על Wan 3.0. שלושת הקירות ננעלו כבר בניסיון הראשון, והשירות מסר את הסרטון.
21% מהתמונה משתנים, ורק באזורים שהמתכנן סימן; כל השאר הוא התמונה המקורית עצמה. לכן ציון החדות, 190, נמצא בין ה־393 של תנועת המצלמה ל־43 של הסרטון הרחב. Wan יצר כל קיר ב־1280 על 720, ההגדרה של השירות ל־Wan, כך שהאזורים שזזים נמתחים פי 1.5 ורכים יותר מהתמונה המקורית שסביבם. ליד נקודות החיבור משתנים 0.02% ו־0.01% מהשטח: הקירות מתחברים בדיוק. עשר שניות של הקובץ המלא שוקלות 9.3 מגה־בייט. הסרטון עלה $3.35: $1.10 לכל סרטון קיר ועוד 5 סנט למתכנן.
סומן לבדיקה. הבדיקות של השירות עצמו סימנו את הסרטון לבדיקה, והסיבה היא הסירה. במהלך 10 השניות היא נסחפת כ־155 פיקסלים שמאלה. השירות שומר את הפיקסלים של המודל רק במקומות שבהם הם משתנים מספיק, ובשאר המקומות ממזג פנימה את התמונה המקורית. סביב ראש התורן של הסירה הוא שמר רק חלק מהם, כך שבמקום שבו הסירה התחילה נשאר העתק חיוור של התורן מהתמונה המקורית כמעט לאורך כל הסרטון. בנוסף, כדי לסגור את הלולאה השירות ממזג את השנייה העודפת של הסרטון בהתחלה שלו, כך שבמשך כשנייה הסירה כולה מופיעה פעמיים: איפה שסיימה ואיפה שהתחילה. המצלמה נשארה יציבה; הסירה היא מה שצריך לבדוק שוב.
בסך הכול שיטה 3 עלתה $17.48 בשני הימים: $11.93 על ארבעת הניסיונות שנדחו, $2.20 על שני הניסיונות של הקיר הימני ו־$3.35 על הסרטון שהתקבל.
יתרונות
- נקודות החיבור לא יכולות לזוז: לידן השתנו 0.02% מהשטח, לעומת 75% עד 100% בשיטות האחרות.
- אתם קובעים מה זז, והקפיצה בלולאה, 0.66, הייתה הקטנה ביותר שמדדנו.
חסרונות
- על מודל ברירת המחדל השירות סירב לסצנה שלנו ארבע פעמים, תמורת $11.93. Wan 3.0 מסר סרטון, אבל ב־1280 על 720 לכל קיר.
- משהו שנע, כמו הסירה, עלול להשאיר העתק חיוור במקום שבו התחיל, ומופיע פעמיים בנקודה שבה הלולאה מתמזגת. שום דבר לא יכול לעבור מקיר לקיר, והמצלמה לא יכולה לזוז.
מתי להשתמש: כשאסור שנקודות החיבור יזוזו, ורק חלקים מהתמונה צריכים לזוז, כמו מים וערפל. אם מודל ברירת המחדל מזיז את המצלמה באחד הקירות, כדאי לנסות את Wan 3.0.
מתי לוותר: כשהתנועה צריכה לעבור מקיר לקיר, או כשמשהו בתמונה נע למרחק גדול במהלך הסרטון.
שיטה 4: לעבור מתמונה אחת לאחרת
- התמונה הראשונה: פנורמת הזריחה.
- התמונה האחרונה: אותה פנורמה בדמדומי ערב. יצרנו אותה בעריכה של תמונת הזריחה ולא בציור מחדש, כדי שהסצנה תישאר אותה סצנה. העריכה נעשתה ב־Seedream 4.5 Edit, עלתה $0.04 ולקחה 33 שניות.
- מודל הווידאו, Wan 3.0, מנפיש את המעבר מהתמונה הראשונה לאחרונה. כמו בשיטה 2, הסרטון שלו, 3324 על 622, מוגדל ל־3838 על 718 ונמתח ל־5760 על 1080. הסרטון הולך וחוזר: מזריחה לדמדומים, ובחזרה.
95% מהתמונה משתנים, כי האור משתנה בכל מקום. ציון החדות הוא 41, קרוב ל־43 של שיטה 2: אותו גודל סרטון ואותה מתיחה. עשר שניות של הקובץ המלא שוקלות 33.7 מגה־בייט. בתמונת הדמדומים הסירה, הגדות, האיים והרכסים נשארו במקומם; רק צורת המפרש השתנתה מעט.
יתרונות
- מספרת סיפור קטן: מעבר בין שעות היום, חילופי עונות, לפני ואחרי.
- לולאת ההלוך־חזור חוזרת להתחלה בלי קפיצה נראית לעין (0.92).
חסרונות
- צריך שתי תמונות שמתאימות זו לזו.
- אותה מגבלה כמו בשיטה 2: סרטון של 3324 על 622, שמוגדל ונמתח עד שהוא ממלא את הקירות.
מתי להשתמש: כשרוצים שהחדר ישתנה, ולא רק יזוז.
מתי לוותר: כשיש רק תמונה אחת ואין דרך ליצור לה תמונה תואמת.
איך יוצרים לולאה: הלוך־חזור, קדימה או בלי לולאה
סרטון לא חייב לחזור על עצמו: אפשר גם להקרין אותו פעם אחת. בדקנו בהקרנה חוזרת כל סרטון שקיבלנו, כי אז הרגע שבו הסרטון מתחיל מחדש הוא חלק מהתוצאה. מודל וידאו שמתחיל מתמונה סטטית מתרחק ממנה, ושום דבר לא מחזיר אותו אליה, כך שהפריים האחרון שונה מהראשון, ובהקרנה חוזרת התמונה קופצת. ל־wallvideo-service יש שלושה סגנונות לולאה. יצרנו את שלושתם מהסרטון של שיטה 2, בלי יצירה חדשה. הסרטונים בעמוד הזה מתנגנים בלולאה, כך שאפשר לראות בעצמכם את נקודת הלולאה בכל אחד מהם.
הלוך־חזור (Bounce) מריץ את הסרטון קדימה ואז אחורה, כך שהוא נגמר בפריים הראשון שלו ונמשך פי שניים. הקפיצה בלולאה, 0.92, קטנה מהשינוי הגדול ביותר בין שני פריימים סמוכים ב־25 הפריימים הראשונים של הסרטון (1.37), כך שנקודת המפנה נראית כמו עוד פריים רגיל. זה מתאים למים, לעננים ולערפל, שנראים טבעיים בשני הכיוונים. גם שיטות 1 ו־4 משתמשות בהלוך־חזור, עם קפיצות של 1.18 ו־0.92.
קדימה (Forward) מריץ את הסרטון קדימה וממזג את 0.75 השניות האחרונות שלו בהתחלה. הקפיצה בלולאה הייתה 4.05 – פחות מחצי מה־9.78 של סרטון שמתנגן פעם אחת. זה מתאים לתנועה שיש לה כיוון, כמו אנשים שהולכים, שנראית משונה כשהיא רצה לאחור. בתיאור של שיטה 2 הוספנו "seamless looping motion, settling back toward the opening", כדי לקרב את הסוף להתחלה עוד לפני המעבר ההדרגתי.
בלי לולאה (None) מריץ את הסרטון פעם אחת, ולסרטון שלא חוזר על עצמו זה מספיק. בהקרנה חוזרת, כמו כאן, הוא קופץ בנקודת הלולאה: 9.78, יותר מפי עשרה מההלוך־חזור.
שיטת קיר אחר קיר (שיטה 3) יוצרת לולאה בדרך אחרת: כל קיר מבקש מהמודל שנייה או שתיים של וידאו עודף, וממזג אותן בהתחלה של הסרטון, כך שכל קיר סוגר את הלולאה בעצמו. ב־Wan 3.0 הקפיצה בלולאה הייתה 0.66, הקטנה ביותר שמדדנו, אבל המיזוג הראה את הסירה הנסחפת פעמיים במשך כשנייה.
תשפטו בעצמכם: תקריבים בגודל מלא ונקודות החיבור
התקריבים הבאים נגזרו בגודל מלא (100%) מאותו מלבן קבוע, מהפריים האמצעי של כל סרטון שהתקבל. בשיטה 1 הפריים האמצעי הוא שיא הזום, ולכן הסירה מעט גדולה יותר; בשיטה 3 רק המים והסירה מגיעים מהמודל, וכל השאר הוא התמונה המקורית; בשיטה 4 זו כבר שעת הדמדומים. כדאי להשוות את המרקם, ולא את התוכן.
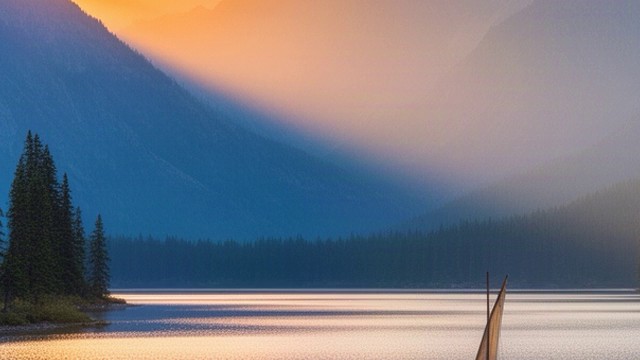
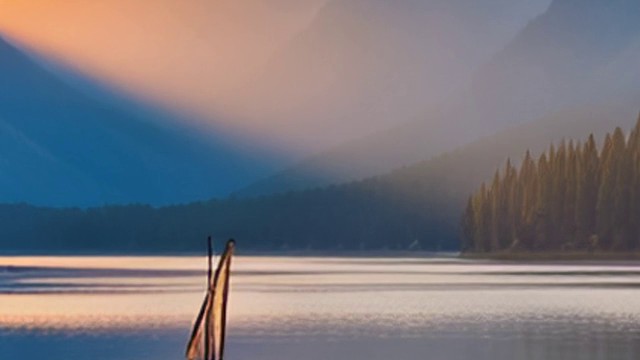
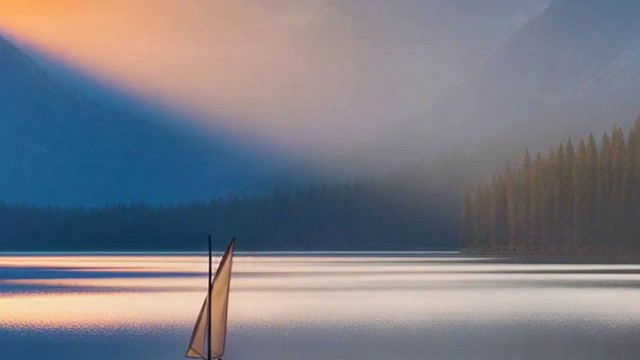
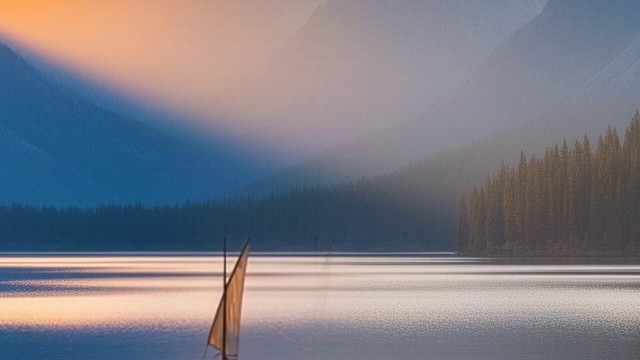
נקודות החיבור בין הקירות הן המקום שבו תמונה שזזה עלולה להישבר:
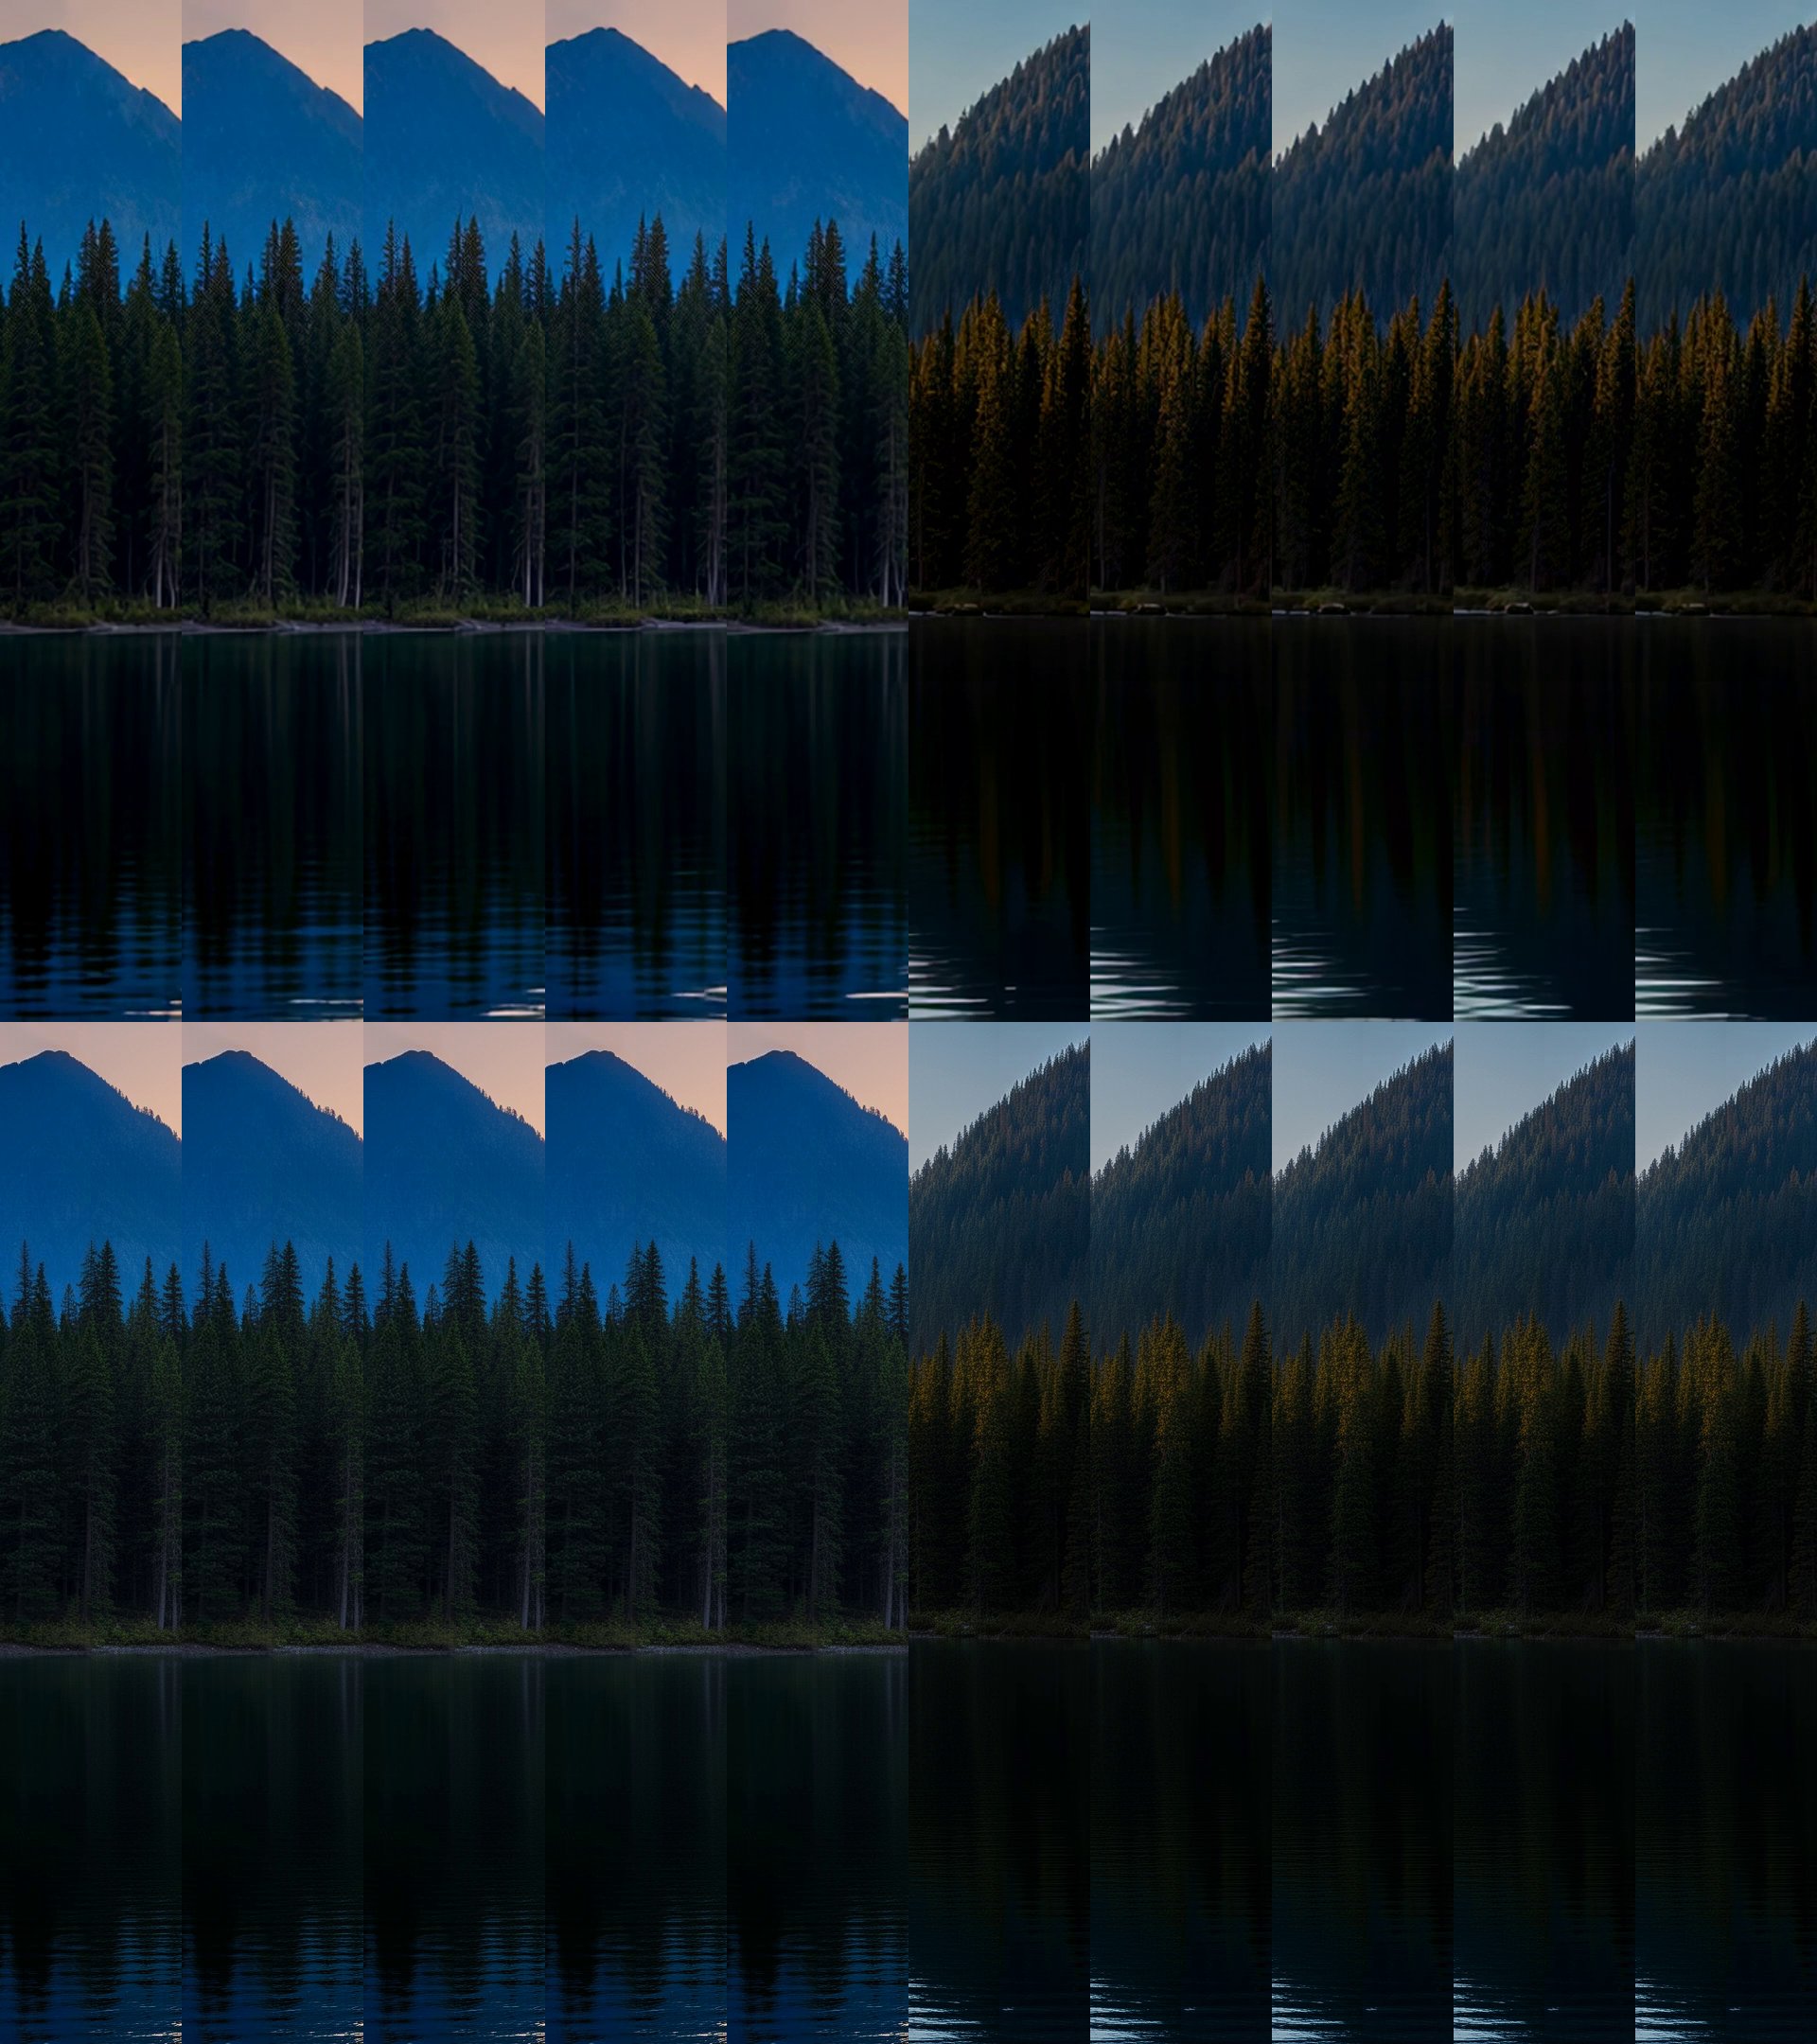
בשיטות 1, 2 ו־4 התמונה זזה על פני שתי נקודות החיבור (לפי המדידה שלנו, 75% עד 100% מהשטח שליד כל נקודת חיבור משתנה), אבל זו תמונה אחת, ולכן הקירות ממשיכים להתחבר. בשיטת קיר אחר קיר כל קיר נוצר בנפרד, ולכן נקודות החיבור חייבות להישאר קבועות: בסרטון שהיא מסרה השתנו 0.02% ו־0.01% מהשטח הזה. זו גם הסיבה שהשירות סירב לקירות שהתקרבו.
מגבלות הבדיקה
- תמונה אחת – נוף בלי אנשים ובלי טקסט – ותיאור תנועה אחד. בסצנות אחרות התוצאות עשויות להיות שונות: הסירובים בשיטה 3 על LTX-2.3 נבעו מקיר אחד בתמונה הזו, ושני הקירות האחרים ננעלו בכל פעם.
- בכתבה מוצגת הרצה אחת של כל שיטה (ובשיטה 3 – ארבעה ניסיונות על LTX-2.3, שני ניסיונות של קיר בודד והרצה אחת על Wan 3.0), כך שהמספרים הם דוגמה ולא ממוצע.
- המחירים, המודלים וברירות המחדל של השירות משתנים; כל המספרים כאן נכונים ל־8 ול־9 בנובמבר 2026.
- מדדנו את הקבצים, לא את האופן שבו החדר מקרין אותם: קצב הפריימים, הקודקים והתזמון של המקרנים תלויים בנגן. בסרטונים אין סאונד.
בשורה התחתונה: איך לבחור שיטה להכנסת תנועה לפנורמה של חדר אימרסיבי
על סמך הבדיקה הזו, כנקודת פתיחה:
- בחינם, מכל תמונה: שיטה 1. שום דבר בסצנה לא זז, אבל החדר מקבל תחושה איטית של תנועה ושומר על כל הפרטים של התמונה.
- מים, שמיים או ערפל שזזים על פני שלושת הקירות: שיטה 2, ב־$3.30 ל־10 שניות. לקירות חדים יותר, SeedVR היה כאן חד בערך פי 2.5, תמורת $0.57 נוספים וכ־19 דקות נוספות.
- שינוי באור, מעבר בין שעות היום או חילופי עונות: שיטה 4, כשאת התמונה השנייה יוצרים בעריכה של הראשונה.
- קירות שמתחברים בדיוק, כשרק חלקים מהתמונה זזים: שיטה 3, ב־$3.35 ל־10 שניות על Wan 3.0. מודל ברירת המחדל סירב לסצנה שלנו, Wan יוצר כל קיר ב־1280 על 720, ומשהו שנסחף רחוק משאיר עקבות חיוורים ומופיע פעמיים בנקודת הלולאה.
- אם הסרטון חוזר על עצמו, לולאה שאף אחד לא שם לב אליה: הלוך־חזור למים, לעננים ולערפל; קדימה עם מעבר הדרגתי לתנועה שיש לה כיוון. במעבר יחיד שמתחיל מחדש רואים את הקפיצה. סרטון שמוקרן פעם אחת בלבד לא צריך אף אחד מהם.
כשהסרטון חשוב, כדאי להפיק אותו בשתי שיטות ולצפות בשני הסרטונים בגודל מלא, כמו שהחדר יקרין אותם: פעם אחת או שוב ושוב.